インサイトは、Omnissa Workspace ONE Experience Management 環境の異常を検出します。これらは機械学習ベースの機能で、興味深い、または問題のある可能性があるデータ ポイントの変化について警告するため、ユーザーがダッシュボードを継続的に監視する必要はありません。
インサイトの仕組み
インサイト アルゴリズムにより、エクスペリエンス管理環境の各データ ポイントの正常動作のベースラインが作成されます。このアルゴリズムは、率が上下するにつれて通常の範囲を調整します。たとえば、アプリのクラッシュ数が時間の経過とともに減少し始めた場合、アルゴリズムはアプリがより安定したと判断し、それに応じて正常と見なされる動作を変更します。
AI 栄養ラベル
| AI 栄養に関する事実 | インサイト |
|---|---|
| 機能名 | インサイト |
| 説明 | エクスペリエンス管理ソリューションでのアノマリー検知 |
| 製品 | エクスペリエンス管理 |
| モデル タイプ | 時系列アノマリー検知 |
| モデル プロバイダ | 内部 |
| 入力データ | Intelligence Data Lake からのテレメトリ |
| ユーザー監査に使用できる入力データ | 該当なし |
| データ主権の遵守 | はい |
| ユーザー コンテンツに関するトレーニング | はい、匿名化済み |
| ガードレール | 該当なし |
| 更新頻度 | モデルは毎週再トレーニングされる |
| データ保持期間 | Intelligence データ保持ポリシーを参照してください |
| 選択性 | エクスペリエンス管理ソリューションの一部として必要 |
インサイトはどこで確認できますか?
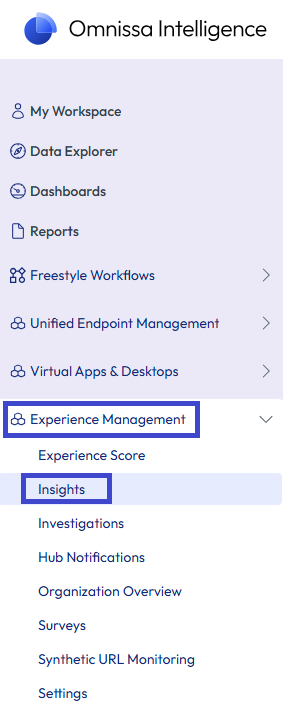
Omnissa Intelligence がアノマリを検出した場合は、[ワークスペース] > [エクスペリエンス管理] > [インサイト] でインサイトを確認できます。
デバイス数の増加に伴うインサイトの向上
デフォルト設定では、インサイトは通常、少なくとも数百台のアクティブなデバイスからテレメトリを利用できる場合に最も効果的です。デバイス数が少ない場合、得られるインサイトが少なくなるか、安定性が低下する可能性があります。デバイスの数が増えると、インサイトの品質と信頼性が向上します。
インサイト カードでできること
カードの矢印 (>) を選択すると、Insights カードからいくつかのアクションを実行できます。
- 調査の作成 - インサイトの調査を作成します。
- コメントの追加 - 他の管理者が確認して分析に使用するコメントを追加します。コメントを使用して、[何を作業したいですか?] セクションの [前回のコメント] メニュー オプションを使用してインサイトをフィルタリングすることができます。
- 破棄 - インサイトをアーカイブされた状態にするには、**[破棄]**を選択します。
- ユーザーに基づいて、[アクティブ] または [破棄済み] のステータスが管理されます。たとえば、管理者 A がインサイトを無視した場合でも、管理者 B には同じインサイトが表示されます。
- インサイトを再アクティブ化する手順は、インサイトを破棄する場合に似ています。
- 検索フィールドの横にあるフィルタを使用して、破棄されたインサイトを表示します。
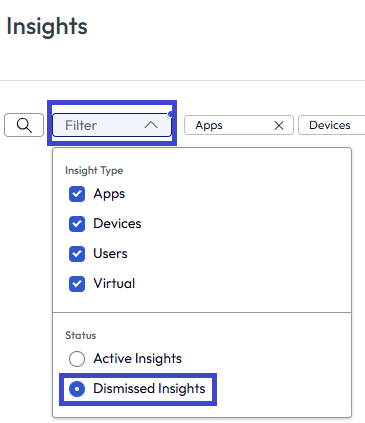
- リストで該当する破棄されたインサイトを見つけ、矢印 (>) を選択します。
- アクティブ化を選択します。
- 検索フィールドの横にあるフィルタを使用して、破棄されたインサイトを表示します。
- 影響を受けるデバイス - インサイトの影響を受けるデバイスの割合と、影響を受けるデバイスのうちアクティブなデバイスの数を確認できます。
- デバイス表示を選択すると、影響を受けるすべてのデバイスがデバイス名別に一覧表示されます。
- [デバイス] タブには、インサイトの影響を受けたデバイスが一覧表示されます。
- デバイス カテゴリについては、[OS バージョンによる影響] タブには、インサイトの影響を受けた OS バージョンが表示されます。
- アプリ カテゴリについては、**[アプリ バージョンによる影響]**タブに、インサイトの影響を受けたアプリのバージョンが表示されます。
- インサイト チャート - 時間の経過に伴うインサイト データ ポイントを表示します。
- アルゴリズムによって履歴データを使用して生成されたデータ ポイントの正常範囲は、青色で表示されます。
- データ ポイントの現在のデータ値は、青い実線で示されます。
- 色の付いた領域に隙間がある場合、それはその期間にデータが報告されなかったことを示します。
- [タイムライン] - このウィジェットには、インサイトの作成時刻と、インサイトが継続的に異常であったすべての期間が表示されます。
インサイトの感度を制御する方法
[インサイト] タブ([エクスペリエンス管理] > [設定])を使用して、インサイト メカニズムの感度と最小しきい値を制御します。 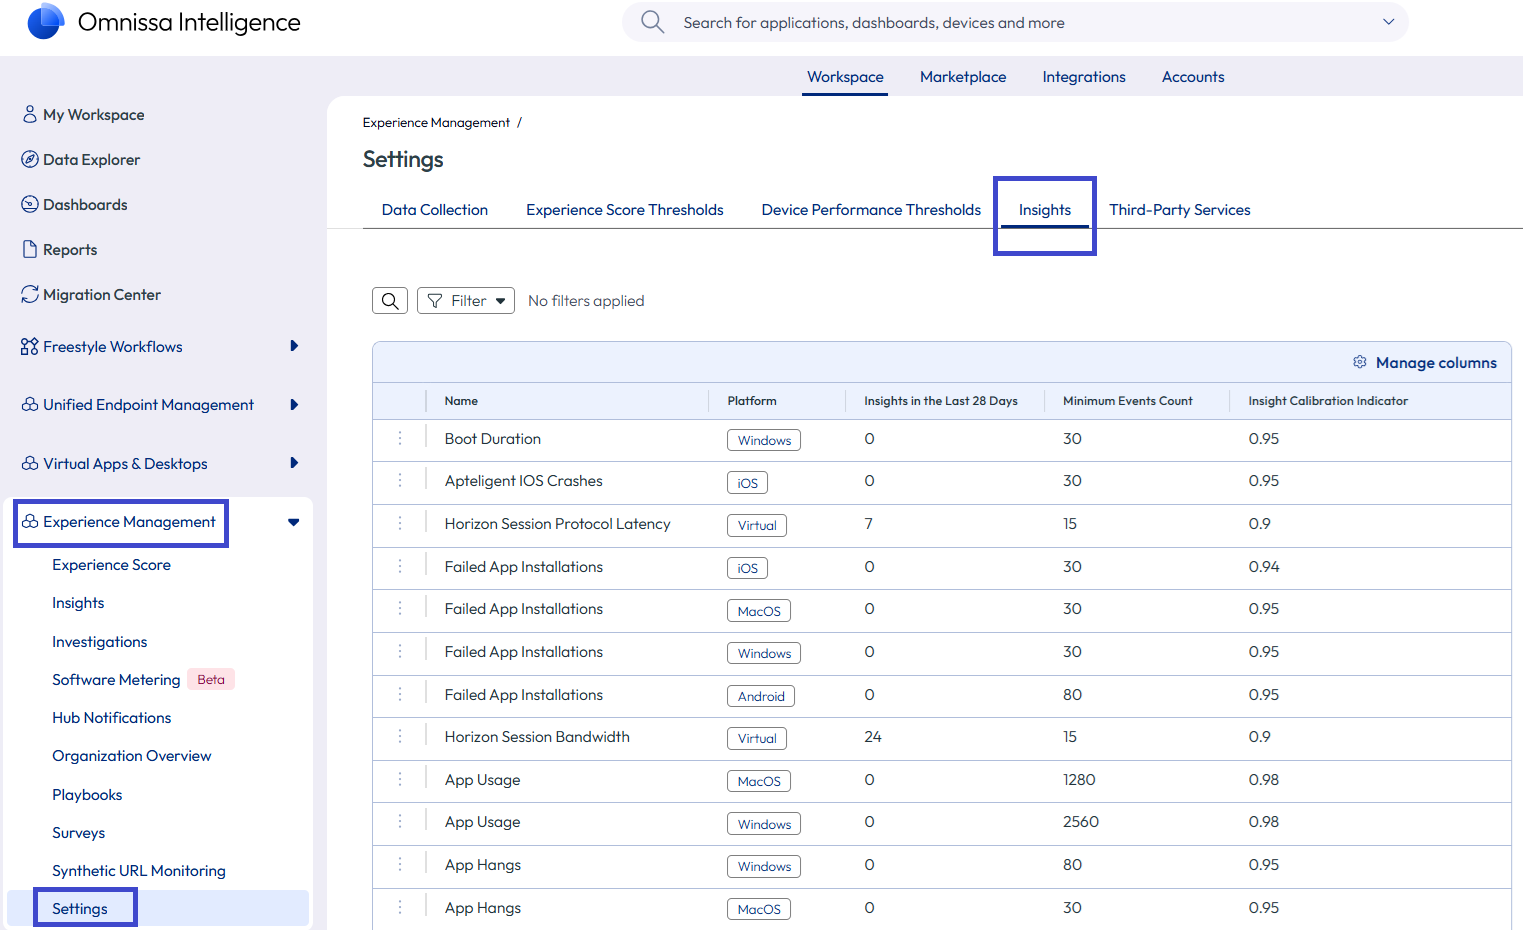
これらのしきい値は、システムにインサイトが殺到している場合、またはビジネス領域がインサイト エンジンによってさらに精査する必要がある場合に役立ちます。インサイトの感度を構成するには、インサイト リストを使用してしきい値を編集します。
- [エクスペリエンス管理] > [設定] の順に移動し、[インサイト] タブを選択します。
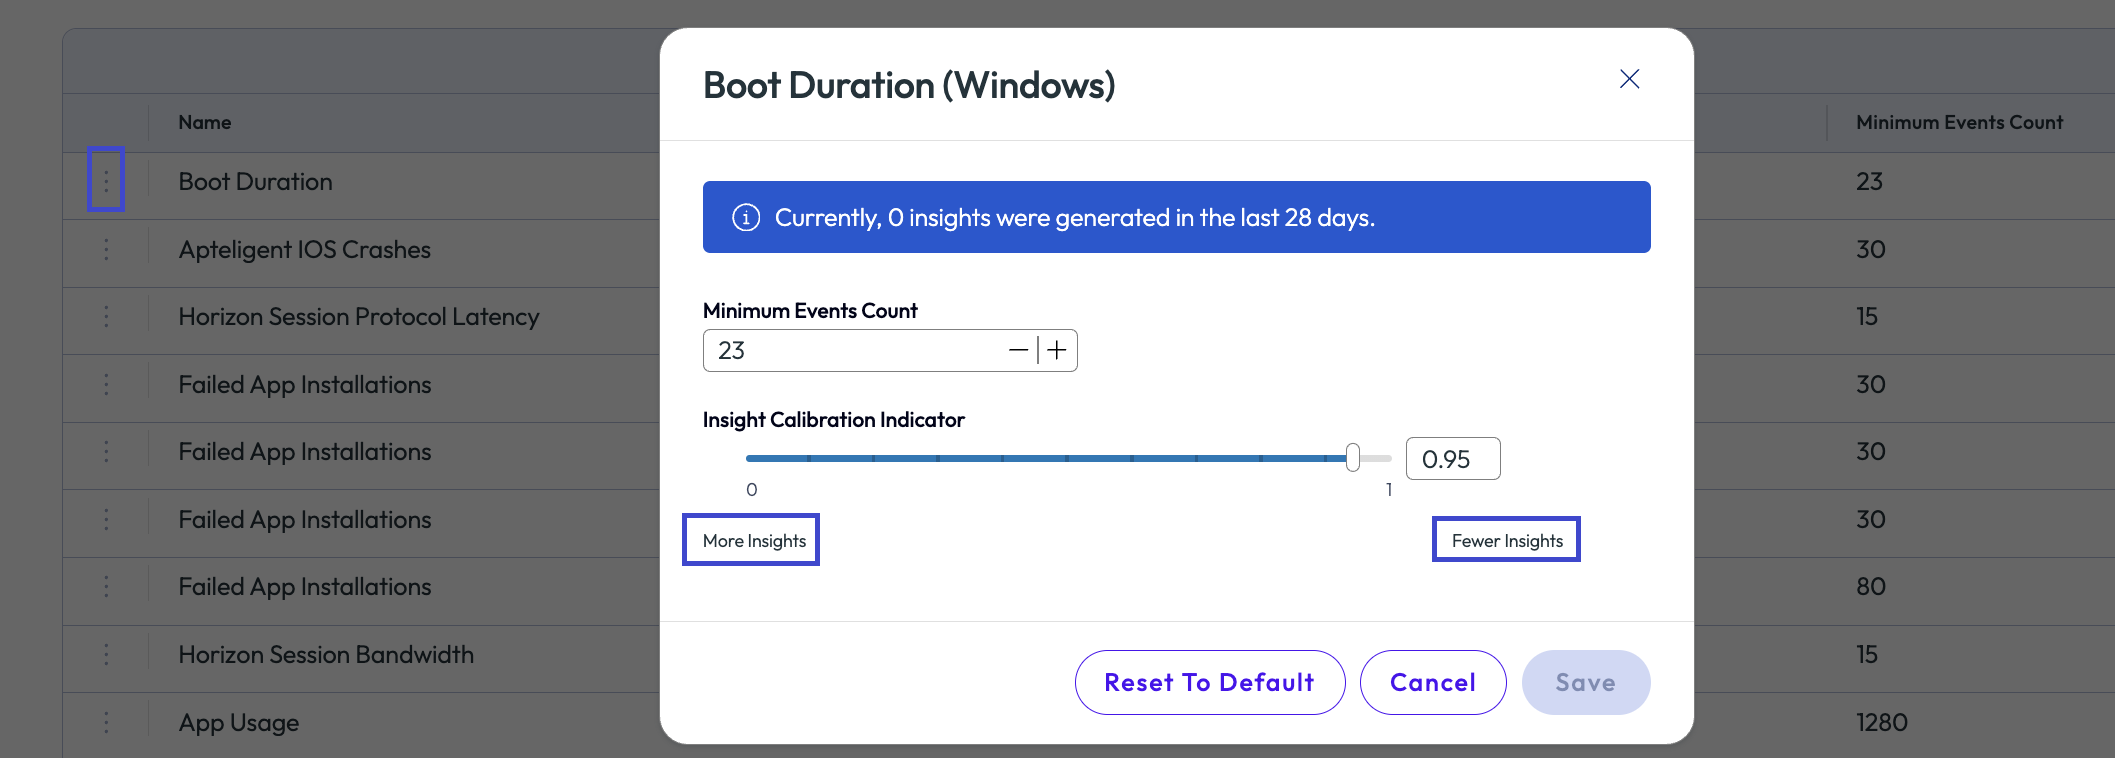
- 該当するインサイトの横にある縦に並んだ 3 つのドットを選択し、[編集] を選択します。
- インサイトのしきい値カードを使用して、イベント数を構成したり、キャリブレーションを増減させたり、インサイトのキャリブレーションをデフォルト設定に戻したりします。
インサイトが監視するデータ ポイント
| データ ポイント | 説明 | 例 | データ ポイント ソース |
|---|---|---|---|
| アプリのクラッシュ | 1 時間ごとのアプリのクラッシュ数。 | 過去 1 時間にアプリが高い頻度でクラッシュし始め、生産性に影響を与えているというインサイトが生成されます。 | Omnissa Workspace ONE Experience Management |
| アプリのハング | 1 時間ごとのアプリのハング数。 | アプリがハングし始め、生産性を低下させているというインサイトが生成されます。 | Omnissa Workspace ONE Experience Management |
| アプリのインストールに失敗 | 特定のアプリで失敗したインストールの数 (1 時間単位)。 | 過去 1 時間に通常よりも高い割合でアプリのインストールに失敗したことを示すインサイトが生成されます。 | Omnissa Workspace ONE UEM |
| アプリの使用状況 | 1 時間ごとのアプリのフォアグラウンド イベント数。Windows、macOS、および Horizon アプリケーションの使用状況について説明します。 | アプリが通常よりも高い頻度で起動しているというインサイトが生成されます。 | Omnissa Workspace ONE Experience Management |
| バッテリ状態の変更 (iOS および Android) | 1 時間ごとのバッテリーイベント数。 | 特定のデバイス群において、充電と放電の切り替わりが通常よりも頻繁に発生し始めた場合、システムは「インサイト(分析結果)」を生成します。これは通常、充電器の故障や非標準的な仕様が原因です。 | Omnissa Intelligence SDK |
| 起動時間 | 1 時間ごとの起動時間の中央値。 | 起動時間の中央値が増加したというインサイトが生成されます。この増加は、広範囲で起動パフォーマンスが低下していることを示唆しています。 | Omnissa Workspace ONE Experience Management |
| CPU 使用率 | 1 時間ごとの CPU 使用率の中央値。 | CPU 使用率の中央値が増加し、最近展開された一部のアプリが異常に高いリソース要件を引き起こしているというインサイトが生成されます。 | Omnissa Workspace ONE Experience Management |
| 失敗した SSO ログイン | 1 時間ごとの失敗した SSO ログイン回数。 | SSO ログイン失敗回数が通常よりも多く登録されていることを示すインサイトが生成されます。これは、従業員が会社のリソースにアクセスできない可能性があることを意味します。 | Omnissa Access |
| Unified Access Gateway の接続数が多い | Unified Access Gateway アプライアンス全体の接続数 (1 時間単位)。 | システムは、Unified Access Gateway アプライアンスが処理している接続の数が通常の範囲を超えたというインサイトを生成します。多くの場合、ロード バランシングの問題、アプライアンスの停止、あるいは需要が処理能力を上回っていることの早期のサインです。環境全体について報告されます。 | Omnissa Workspace ONE Experience Management |
| Unified Access Gateway での高い CPU 使用率 | Unified Access Gateway アプライアンス全体の CPU 使用率の中央値 (1 時間単位)。 | システムは、Unified Access Gateway アプライアンス全体の CPU 使用率が通常の範囲を超えたというインサイトを生成します。これは、デスクトップごとのすべてのメトリックが健全に見えても、ゲートウェイの背後にいるすべてのユーザーの接続仲介機能を低下させる可能性があります。環境全体について報告されます。 | Omnissa Workspace ONE Experience Management |
| 仮想マシンでの高い CPU 使用率 | Horizon 仮想マシン全体の CPU 使用率の中央値 (1 時間単位)。システムは、アクティブなセッションを持つ仮想マシンのみをカウントします。 | システムは、Horizon 仮想マシン全体の CPU 使用率が通常の範囲を超えたというインサイトを生成します。 | Omnissa Workspace ONE Experience Management |
| 仮想マシンのディスク遅延が大きい | Horizon 仮想マシン全体のストレージ ディスク遅延の中央値 (1 時間単位)。 | システムは、Horizon 仮想マシン全体のストレージ ディスク遅延が通常の範囲を超えたというインサイトを生成します。これは、明らかにおかしいメトリックが他に見当たらないのにデスクトップの動作が遅く感じられる原因となっていることがよくあります。 | Omnissa Workspace ONE Experience Management |
| 仮想マシンでの高いメモリ使用率 | Horizon 仮想マシン全体のメモリ使用率の中央値 (1 時間単位)。 | システムは、Horizon 仮想マシン全体のメモリ使用率が通常の範囲を超えたというインサイトを生成します。これによりアナリストは影響を受ける仮想マシンを特定のデスクトップ プールに関連付けます。 | Omnissa Workspace ONE Experience Management |
| Horizon セッション帯域幅 | 1 時間におけるセッション帯域幅(送信バイト数)の中央値。 | セッション帯域幅の中央値が急増したというインサイトが生成されます。 | Omnissa Workspace ONE Experience Management |
| Horizon セッション遅延 | 1 時間におけるプロトコル遅延の中央値。 | すべての Horizon セッションのプロトコル遅延の中央値が急増したというインサイトが生成されます。 | Omnissa Workspace ONE Experience Management |
| Horizon セッション ログイン時間 | 1 時間ごとのログイン時間の中央値。 | ログイン時間の中央値が増加したというインサイトが生成されます。この増加は、広範囲でログイン パフォーマンスが低下していることを示しています。 | Omnissa Workspace ONE Experience Management |
| Horizon セッションのパケット ロス | 1 時間におけるゼロ以外のパケット ロス セッションの数。 | パケット ロスが発生したセッションの合計量が、所定の時間の正常値を超えるというインサイトが生成されます。 | Omnissa Workspace ONE Experience Management |
| Intelligence SDK のクラッシュ (iOS および Android) | Intelligence SDK を使用するアプリからの 1 時間ごとのアプリのクラッシュ数 | 過去 1 時間にアプリが高い頻度でクラッシュし始め、生産性に影響を与えているというインサイトが生成されます。 | Omnissa Intelligence SDK |
| Intelligence SDK ネットワーク エラー (iOS および Android) | Intelligence SDK を使用するアプリからの 1 時間ごとのネットワーク エラー数 | Intelligence SDKを組み込んだアプリにおいて、通常よりも多くのネットワークエラーが記録された場合、システムはインサイトを生成します。 | Omnissa Intelligence SDK |
| ネットワーク状態の変更 (iOS および Android) | 1時間単位でのネットワーク状態変更イベントの数。 | 組織またはプラットフォームのレベルで、デバイスのネットワークイベントが急激に増加または減少した際、システムはインサイトを生成します。スパイクは通常、デバイスがネットワーク間(Wi-Fi からセルラー、5G から 4G)を通常よりも速く切り替えている状態を意味します。ドロップは通常、アップストリームのネットワークが停止していることを意味します。 | Omnissa Intelligence SDK |
| OS のクラッシュ | 1 時間ごとの OS クラッシュ数。 | OS クラッシュ数が過去の正常値を超えているというインサイトが生成されます。この増加は、広範な BSoD(ブルー スクリーン)の問題を示唆しています。 | Omnissa Workspace ONE Experience Management |
| ネットワーク信号の不良 (Android) | 1時間単位での、信号状態不良のネットワークイベントの数。 | システムは、通常よりも多くのデバイスが弱いセルラー信号(1〜2本のバー)を報告し始めると、インサイトを生成します。ヘルプ デスク チケットの波として表示される前に識別可能な場合があります。通信事業者との会話を先取りし、影響を受ける場所を特定します。 | Omnissa Intelligence SDK |
| シャットダウン時間 | 1 時間ごとのシャットダウンの中央値。 | シャットダウン時間の中央値が増加したというインサイトが生成されます。この増加は、広範囲でシャットダウン パフォーマンスが低下していることを示唆しています。 | Omnissa Workspace ONE Experience Management |
| ユーザー フローの完了時間 (iOS および Android) | ユーザー フロー時間の中央値 (ミリ秒単位) (1 時間単位)。ユーザー フローは、Omnissa Intelligence SDK アプリ内の主要なワークフローを追跡します。システムは、それらを組織、プラットフォーム、アプリ、およびフロー名の順に並べ替えます。 | 完了時間が急増すると、システムが「インサイト」を生成するため、サポートチケットが山積みになる前に、処理の遅延(倉庫でのネットワーク障害によるチェックアウトのタイムアウトなど)を早期に把握することができます。 | Omnissa Intelligence SDK |
| ユーザー フローの失敗 (iOS および Android) | 1 時間の時間枠で失敗したフローの数。ユーザー フローは、Omnissa Intelligence SDK アプリ内の主要なワークフローを追跡します。システムは、それらを組織、プラットフォーム、アプリ、およびフロー名の順に並べ替えます。 | フローの障害発生率が急増すると、システムが「インサイト」を生成するため、サポートチケットが山積みになる前に、処理の遅延(倉庫でのネットワーク障害によるチェックアウトのタイムアウトなど)を早期に把握することができます。 | Omnissa Intelligence SDK |
このページは役に立ちましたか?